Dans Microsoft 365, un fichier sensible n’est pas nécessairement un fichier bien protégé. Un contrat, un tableau de rémunérations ou un projet d’acquisition peut être stocké dans SharePoint, Teams ou OneDrive avec des accès plus larges que nécessaire.
L'enjeu est mesurable. Selon IBM, 2026, le coût moyen mondial d'une violation de données atteint 4,99 millions de dollars, en hausse de 12 % sur un an. Selon le baromètre CESIN, 2026, 40 % des entreprises interrogées ont subi au moins une cyberattaque significative en 2025. Selon le Verizon DBIR 2026, l'élément humain est présent dans 62 % des violations analysées. Selon Microsoft, 2026, 32 % des incidents de sécurité des données des organisations interrogées impliquent des outils d'IA générative.
Ces chiffres ont un point commun : ils dépendent de ce que l'entreprise sait de ses propres données. Or, dans Microsoft 365, la plupart des données sensibles ne sont pas créées par l'IT. Elles sont créées par les métiers. Cet article explique comment les identifier, pourquoi la classification classique demande du temps avant de produire une priorisation, et comment le module MyDataClassification d'IDECSI aborde le problème en s'appuyant sur les propriétaires des données.
Les données sensibles de Microsoft 365 sont créées par les métiers
La DSI administre Microsoft 365, mais ce sont les métiers qui produisent, stockent et partagent leurs données et parmi elles, les données critiques :
- Juridique : contrats, dossiers de contentieux, échanges avec les cabinets d'avocats.
- Ressources humaines : rémunérations, évaluations, dossiers de recrutement.
- Finance : budgets, prévisions non publiées, coordonnées bancaires.
- Marketing : plans de lancement, budgets de campagne, listes de prospects.
- Direction générale et COMEX : projets stratégiques, comptes rendus, dossiers d'acquisition.
Chaque partage est une décision métier, prise en quelques secondes et pour de bonnes raisons : ouvrir un dossier à un cabinet de recrutement, inviter un consultant dans une équipe Teams, envoyer un lien à un fournisseur. L'accès, lui, reste actif bien après la fin du besoin.
Un indice aide à repérer ces données : le nom du fichier est souvent révélateur de son contenu. Un classeur nommé "Paie_Septembre.xlsx" dans un espace RH, ou un document "Cession_Projet_Atlas.docx" dans l'espace de la direction, n'a pas besoin d'être lu pour être qualifié. Le titre, le type de fichier, l'emplacement et le contexte de partage en disent déjà beaucoup.
Cette réalité pose une limite. La DSI voit les accès, mais pas leur légitimité. Elle ne sait pas si tel prestataire travaille encore sur le dossier, ni si tel document est confidentiel. Seul le propriétaire de la donnée peut répondre à la question : cet accès est-il encore justifié ?
Le DSPM : localiser, identifier, mesurer, prioriser
Le DSPM (Data Security Posture Management) est une approche qui consiste à découvrir où se trouvent les données sensibles, à savoir qui y accède, à évaluer comment elles sont exposées, puis à prioriser les actions pour réduire le risque. Selon Microsoft, 2026, plus de 80 % des organisations interrogées mettent en place ou développent une stratégie DSPM.
Quatre questions structurent la démarche :
- Où se trouvent les données sensibles ?
- Qui y accède ?
- Comment sont-elles exposées : partages, accès externes, liens anonymes, permissions excessives ?
- Quelles actions faut-il traiter en premier ?
La classification répond à la première question. Les trois suivantes décident de l'effort réel de remédiation. Une classification sans lecture des accès produit un inventaire, pas une réduction du risque.
La classification classique avec Microsoft Purview : ce qu'elle demande en amont
Microsoft Purview identifie le contenu sensible avec plusieurs mécanismes : les types d'informations sensibles (SIT), qui détectent des motifs comme des numéros de carte bancaire, les entités nommées, la correspondance exacte de données (EDM) et les classifieurs pouvant être formés. Les étiquettes de confidentialité permettent ensuite de marquer et de protéger les fichiers.
Cette approche est puissante, mais elle suppose un travail préalable que la documentation Microsoft Learn décrit elle-même :
- Le guide de déploiement "secure by default" indique que l'approche classique est souvent difficile ou lente à adopter, notamment à cause de la définition de la taxonomie d'étiquettes, des craintes liées au chiffrement et d'une adoption limitée de l'étiquetage manuel ou automatique seul.
- Un classifieur personnalisé demande au moins 50 exemples positifs et 150 exemples négatifs, placés dans des dossiers SharePoint dédiés, avec des fichiers texte uniquement.
- L'étiquetage automatique impose une simulation avant activation, qui peut durer 12 heures, et plafonne à 100 000 le nombre de fichiers étiquetés par jour et par tenant. Les types d'informations sensibles ne s'appliquent qu'aux contenus créés ou modifiés après leur création, sauf classification à la demande.
- L'étiquetage automatique n'est pas inclus dans les licences E3 ni Business Premium. Il demande une licence de niveau E5 ou équivalent.
La page d'introduction de ce guide s'adresse aux administrateurs et ne traite pas de l'implication des métiers.
Côté exposition, Microsoft précise que Microsoft 365 Copilot s'appuie sur les contenus auxquels l'utilisateur a la permission d'accéder, et qu'une surexposition apparaît quand les permissions d'un site ne correspondent pas à la sensibilité de son contenu. L'évaluation de surexposition de DSPM for AI compare les étiquettes appliquées aux fichiers et l'étendue des accès au site.
Ces contraintes ne remettent pas en cause l'intérêt de Purview. Elles montrent qu'une classification complète demande du temps de préparation avant de produire une priorisation.
MyDataClassification : identifier les données sensibles automatiquement
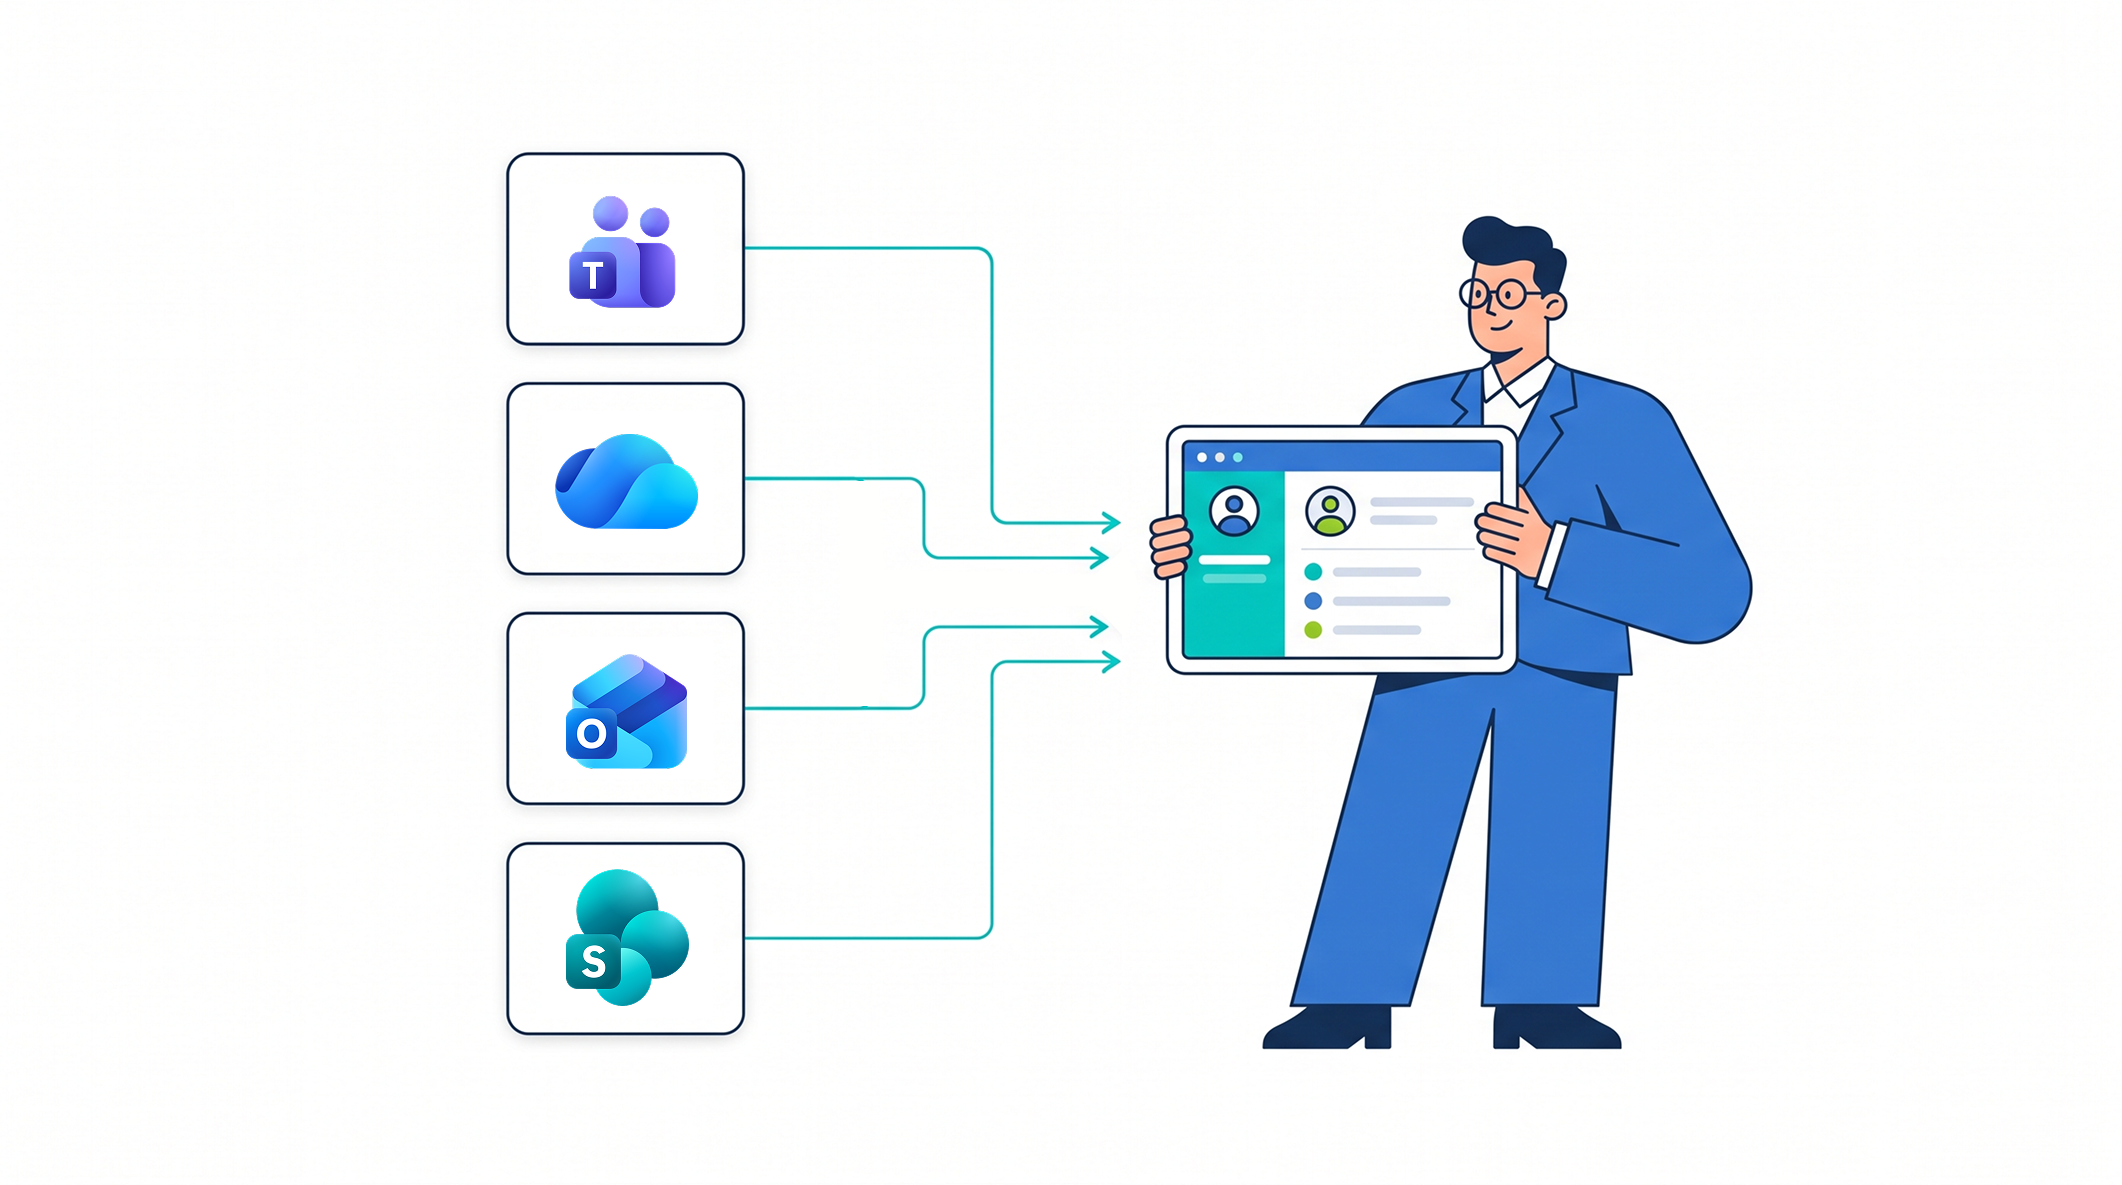
MyDataClassification est le module de la plateforme IDECSI dédié à la classification des données assistée par IA. Il identifie automatiquement les fichiers et les utilisateurs sensibles d'un tenant Microsoft 365 : Teams, SharePoint et OneDrive. Il se suffit à lui-même : aucun déploiement de Purview n'est nécessaire pour qu'il fournisse ses résultats. Si Purview est déjà en place, le module est complémentaire.
Classer les fichiers à partir de leurs métadonnées
Le principe est simple : chaque métadonnée est un indice, et leur association fait la classification. Le module croise trois familles de signaux :
- Le document : titre, type de fichier, étiquettes éventuelles.
- L'emplacement : Teams, SharePoint, OneDrive.
- Le contexte : métier concerné, partages, accès externes.
Chaque fichier reçoit un niveau de sensibilité, de 1 (faible) à 4 (critique), accompagné d'une justification et d'un indice de confiance. Exemple illustratif : un classeur de paie situé dans l'espace RH, accessible par un lien anonyme actif, est classé niveau 4. Le module remonte aussi les fichiers sensibles sans étiquette et les étiquettes incohérentes.
Mesurer l'exposition pour prioriser la remédiation
Le module ne s'arrête pas à la sensibilité. Il la croise avec les accès réels : partages, accès externes, liens anonymes, permissions excessives. Il évalue ainsi le niveau d'exposition des données sensibles, pour que la remédiation se concentre d'abord sur les données qui portent le risque, plutôt que sur l'ensemble du tenant.
Cette lecture répond à l'enjeu Copilot. Un fichier sensible trop partagé peut remonter en une seule question posée à l'assistant. MyDataClassification repère ces données exposées avant le déploiement.
Classer aussi les utilisateurs
Le module qualifie également les profils à enjeu, au-delà du seul COMEX. Il croise l'identité et l'organisation (fonction, organigramme, Entra ID), les comportements, les données manipulées et le contexte métier. Chaque utilisateur reçoit un niveau de sensibilité de 1 à 4. Ce niveau permet d'adapter l'alerting aux profils sensibles, de cibler les campagnes et de pondérer les points d'attention.
Ce que garantit le module
- Confidentialité : aucun contenu de fichier n'est lu et aucun apprentissage n'est réalisé sur vos données.
- Explicabilité : chaque niveau est justifié et accompagné d'un indice de confiance.
- Contrôle humain : vos équipes valident ou corrigent la classification, par une boucle de retour.
- Compatibilité : le module fonctionne sans Purview et s'aligne sur les étiquettes Purview existantes grâce au mapping.
Associer les propriétaires des données à la revue des risques
Classer et mesurer ne suffit pas : quelqu'un doit décider si un accès est encore justifié. Ce quelqu'un est le propriétaire de la donnée, pas l'IT. C'est le principe d'IDECSI : l'IT orchestre, les utilisateurs remédient. L'IT supervise et pilote les campagnes et consolide les résultats. Les propriétaires et les utilisateurs corrigent leurs propres partages.
MyDataClassification applique ce principe. Les utilisateurs peuvent rétroclassifier, les administrateurs assurent le suivi. La remédiation s'appuie ensuite sur l'offre IDECSI : DETOX, ESSENTIAL ou ADVANCED.
Par où commencer : cinq étapes
- Cartographier les directions qui détiennent des données sensibles : juridique, RH, finance, marketing, direction générale.
- Identifier les fichiers sensibles et mesurer leur exposition : partages externes, liens anonymes, accès ouverts à toute l'entreprise.
- Prioriser : traiter d'abord ce qui est à la fois sensible et exposé.
- Faire valider par les propriétaires, puis suivre : revue des accès par les métiers, indicateurs suivis par la DSI et le RSSI.
En résumé : ce que change MyDataClassification
Classer sans impliquer les propriétaires donne une cartographie, pas une réduction du risque. MyDataClassification relie les deux : il identifie les fichiers et les utilisateurs sensibles à partir des métadonnées, mesure leur exposition, puis met la remédiation entre les mains de ceux qui savent si un accès est encore justifié. Les équipes de sécurité obtiennent une priorisation exploitable dès le premier jour, avec ou sans Purview, et les métiers deviennent acteurs de la revue des risques. Le module peut être présenté en démonstration sur demande.
Contacter un expert IDECSI